Un cliente llama para preguntar por un pago a plazos. Empieza en mandarín, usa el nombre del producto en inglés, hace una pausa para comprobar un detalle y se corrige: «不是 credit card,是 instalment plan». No habla de su tarjeta de crédito, sino de un plan de pagos a plazos.
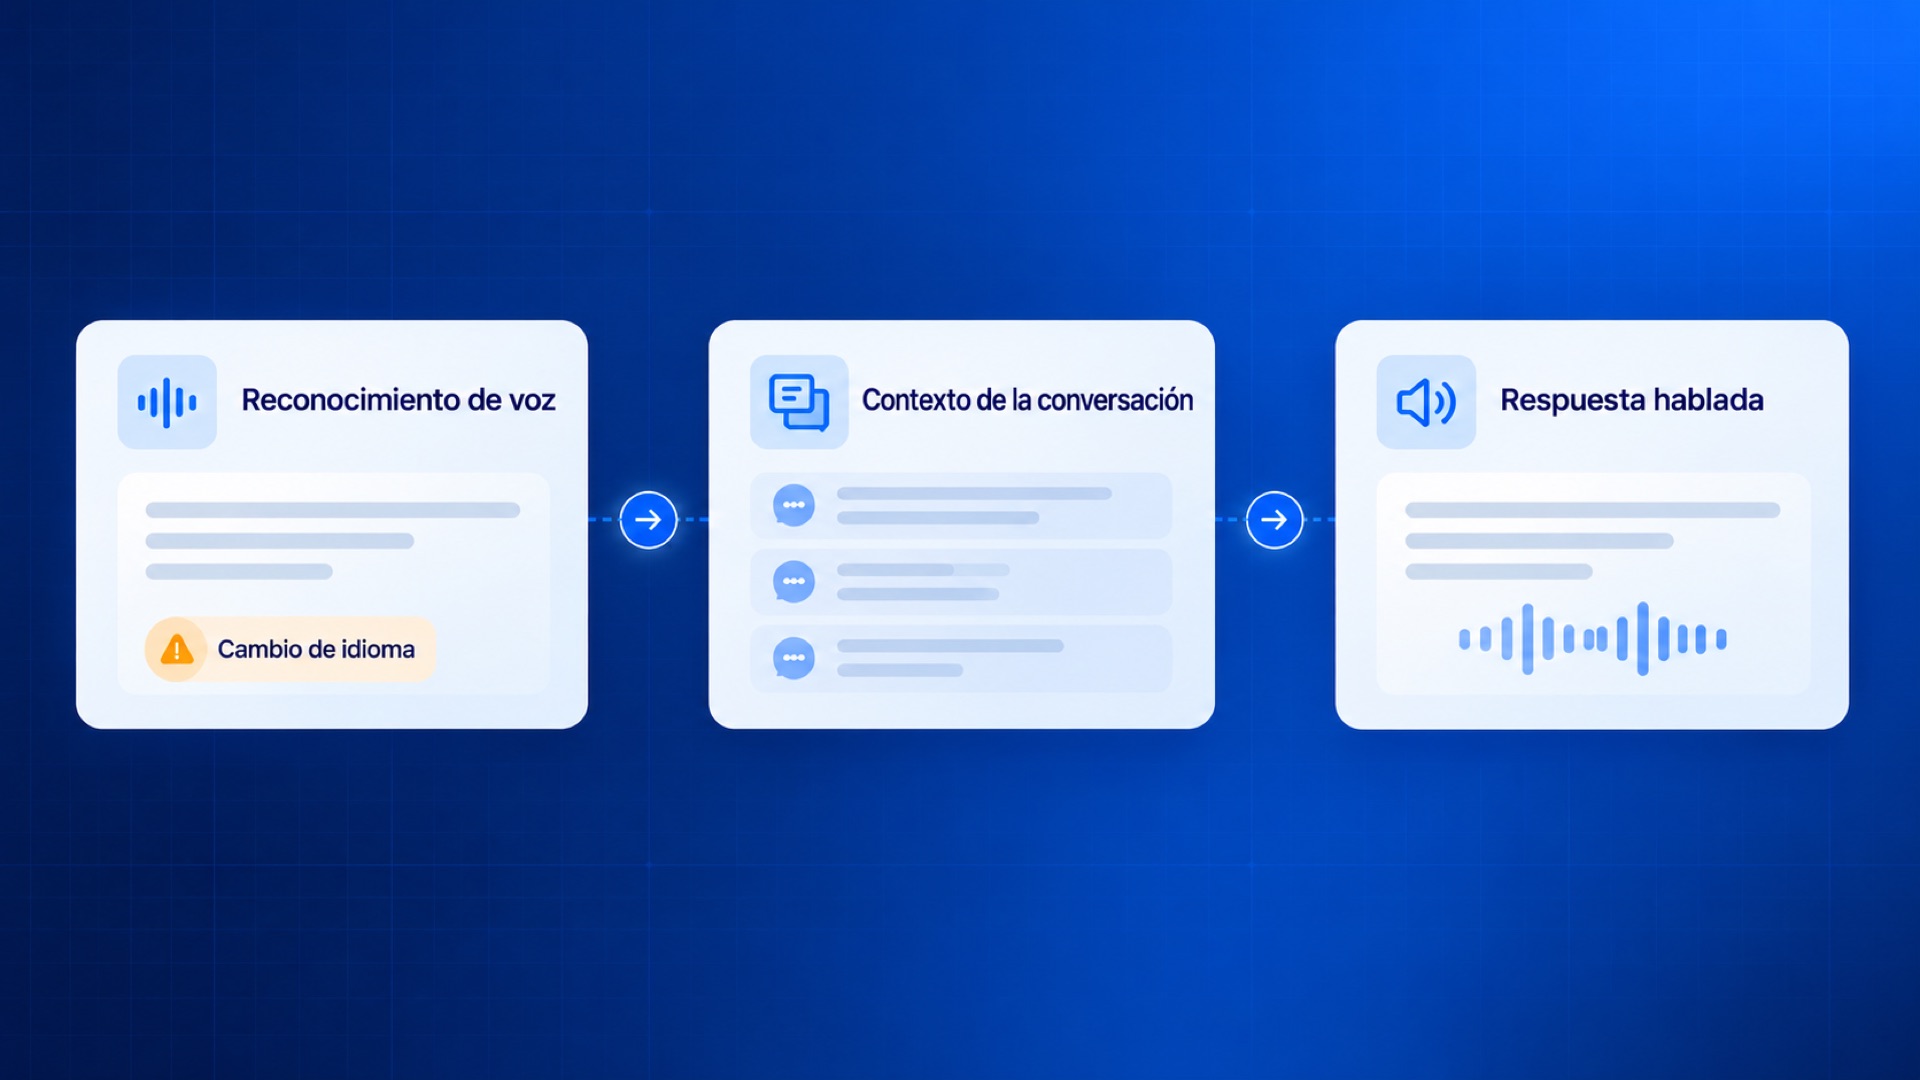
Para el cliente es una consulta corriente. Para un sistema de voz con IA, plantea varios retos a la vez: reconocer dos idiomas por teléfono, conservar la corrección y responder sin obligar al cliente a empezar de nuevo. Si solicita información específica de su cuenta, también tiene que encontrar los datos correctos y seguir las reglas de la empresa para compartirlos.
Esa es la diferencia entre admitir varios idiomas y gestionar una conversación multilingüe. Lo primero significa que un sistema puede procesar más de un idioma. Lo segundo exige seguir lo que quiere decir una persona cuando sus palabras, pronunciación e intención cambian en tiempo real.
Para los equipos que desarrollan o seleccionan un agente de voz, la cuestión no es solo si el modelo puede transcribir una frase. Es si todo el sistema puede escuchar al cliente, seguir la conversación y ayudar a que su solicitud avance hacia un resultado útil.
Por qué es más difícil cambiar de idioma durante una llamada
Los clientes no avisan antes de cambiar de idioma. En Hong Kong, una persona puede hablar en cantonés y usar el nombre de un producto en inglés. En Singapur, una conversación puede combinar inglés, mandarín y expresiones locales. Un hablante de árabe puede usar un dialecto local junto con términos en inglés. Son ejemplos de cómo pueden hablar algunas personas, no reglas aplicables a toda una región.
La dificultad no depende solo de la cantidad de idiomas. Una palabra prestada puede pronunciarse con acento local; el nombre de un producto puede sonar como una frase cotidiana; el ruido puede ocultar la sílaba que permite distinguirlos. Cuando el cliente corrige un dato, el sistema debe reconocer tanto la corrección como aquello que sustituye.
El audio telefónico añade otra limitación. Algunas redes telefónicas tradicionales usan audio de banda estrecha con 8.000 muestras por segundo. En comparación con la banda ancha, el sistema de reconocimiento dispone de menos información acústica. El ruido, una conexión deficiente o la distancia del hablante al micrófono pueden dificultar aún más la identificación de una palabra.
Por eso, los resultados con grabaciones limpias dicen poco por sí solos sobre el desempeño en llamadas reales de un centro de contacto. El modelo debe trabajar con el audio que recibe y el sistema debe reconocer cuándo la señal no es suficientemente clara para responder con seguridad.
De la voz al significado: identificar los datos importantes
El reconocimiento automático de voz (ASR) convierte el habla en un formato que el sistema puede procesar. En una frase que mezcla idiomas, puede ser necesario distinguir patrones lingüísticos, pronunciaciones locales y vocabulario empresarial dentro de una misma intervención. Un nombre de producto en inglés pronunciado con acento local debe seguir siendo identificable aunque el resto de la frase esté en otro idioma.
Dyna.Ai desarrolla modelos de voz para condiciones de conversación reales, como el habla que mezcla idiomas, los acentos y el ruido de fondo. Su Voice Agent está diseñado para manejar formas locales de hablar en conversaciones con clientes. Esto importa cuando una persona no usa las palabras exactas de un guion o intercala el nombre de un producto en otro idioma.
La calidad del reconocimiento suele medirse mediante la tasa de error por palabra (WER) o por carácter (CER). Ambas comparan una transcripción con un texto de referencia y cuentan sustituciones, eliminaciones e inserciones. En voz multilingüe también hace falta definir reglas consistentes para la escritura, los alfabetos y la separación de palabras antes de comparar resultados. Una investigación sobre voz que mezcla árabe e inglés ilustra las dificultades de representar estas transcripciones.
La tasa de error general es útil, pero no muestra todo el impacto en el negocio. Confundir un tipo de cuenta, un importe o una negación puede cambiar la solicitud. Un agente puede responder con fluidez y, aun así, contestar a la pregunta equivocada. Por eso conviene considerar conjuntamente el reconocimiento y la comprensión posterior.
Comprender una conversación que cambia de rumbo
Una transcripción no es un registro completo de atención. El sistema también debe conservar la intención del cliente, la información ya establecida y los cambios que haga durante la conversación.
Cuando una persona corrige «tarjeta de crédito» por «plan de pagos a plazos», el sistema debe tratar la segunda expresión como una corrección, no como otro tema. Si después pide realizar un pago, esa es una acción nueva y diferente de su solicitud anterior de información. El contexto relevante debe acompañar la conversación sin convertir una suposición previa en una instrucción.
Un diseño habitual consiste en mantener un estado estructurado de la conversación: valores como el producto seleccionado, la acción solicitada y el estado de confirmación se actualizan a medida que avanza el diálogo. Los parámetros de sesión de Dialogflow CX son un ejemplo de este patrón general. La implementación varía según la plataforma, pero el principio es el mismo: una corrección debe reflejarse en la información que se usa para la siguiente respuesta o acción.
La velocidad implica una decisión. Procesar resultados parciales de voz permite preparar la respuesta antes, pero una frase incompleta puede no incluir todavía las palabras que cambian su sentido. Buscar orientación general mientras el cliente habla puede ser útil. Ejecutar una acción relevante antes de que termine o dé la confirmación necesaria es otra cuestión. Conviene separar la preparación anticipada de una acción autorizada.
Además de palabras, la voz transmite pausas, énfasis y tono. Una pausa puede indicar que el cliente está pensando, no que ha terminado. Un cambio de tono puede sugerir que la conversación necesita atención, pero no permite saber con certeza qué siente alguien o quién es. El sistema debe responder al contexto, incluida una petición clara de hablar con una persona.
Una conversación natural depende del momento y de la calidad de la voz
Los clientes no respetan turnos tan ordenados como los de un chat. Interrumpen, añaden un detalle a mitad de una respuesta o cambian de opinión. Si el agente sigue hablando por encima de ellos, incluso una respuesta correcta puede hacer que la conversación falle.
Gestionar una interrupción requiere varias decisiones: detectar que el cliente habla, detener o ajustar el audio de salida e interpretar lo nuevo en su contexto. Una reacción lenta dificulta la corrección; un sistema que reacciona a cualquier ruido o breve señal de escucha puede detenerse innecesariamente. El equilibrio depende del entorno y del tipo de conversación.
El procesamiento en streaming puede reducir la espera entre el final del turno del cliente y el inicio de la respuesta. En lugar de esperar a que cada etapa termine para comenzar la siguiente, una canalización puede procesar el audio entrante y preparar la salida de forma solapada. El motor de inferencia desarrollado por Dyna.Ai utiliza streaming paralelo para el reconocimiento de voz, la comprensión del lenguaje y la síntesis de voz. Su objetivo es mantener la conversación en marcha mientras el sistema sigue procesando el audio recibido.
La rapidez por sí sola no define la experiencia. Cuando el cliente interrumpe, el sistema también debe gestionar el audio que ya está en espera para reproducirse. Por ejemplo, en un Twilio Media Stream bidireccional, una aplicación puede enviar un mensaje clear para vaciar el audio almacenado. Los controles disponibles varían según el sistema telefónico. Detener el audio tampoco revierte una acción ya enviada a otro sistema; eso requiere el proceso de negocio adecuado.
La voz también importa cuando el agente ya tiene algo útil que decir. Dyna TTS ofrece síntesis adaptada a cada idioma, incluida la entonación y la terminología empresarial en japonés y la voz en cantonés para Hong Kong. Su voz en árabe admite texto que mezcla árabe e inglés y orientación de pronunciación para nombres locales y términos sectoriales.
La naturalidad va más allá de elegir una voz agradable. Los nombres de productos, préstamos lingüísticos, fechas e importes deben entenderse en el idioma y el contexto de la conversación. Una respuesta fluida que no permite comprender un importe puede dejar al cliente sin saber qué ocurrirá después.
De una buena conversación a una tarea completada
La voz con IA aporta valor cuando la conversación conduce a una acción. Un cliente puede necesitar una respuesta; un posible comprador, un seguimiento; y una persona contactada sobre un pago, un siguiente paso adecuado. Cada flujo requiere información y permisos diferentes.
Dyna.Ai Voice Agent combina capacidades de voz y conversación con flujos de trabajo configurados. En atención al cliente, Customer Service Agent puede responder a preguntas con conocimiento aprobado y derivar una solicitud a una persona cuando sea necesario. Si la información de una cuenta o una acción requiere acceder a otro sistema, el flujo necesita las integraciones y autorizaciones correspondientes.
Esta distinción importa cuando no se puede completar algo durante la llamada. Si la consulta de la cuenta no está disponible, una voz natural no puede inventar el saldo. El cliente necesita saber qué se puede hacer a continuación, y el empleado que recibe el caso necesita el contexto relevante para continuar. Una buena derivación forma parte del servicio.
Un banco digital líder de Singapur aplicó este enfoque a sus llamadas de cobranza. Necesitaba contactar a más clientes y atender conversaciones en inglés, Singlish y mandarín, con acentos locales y condiciones reales de llamada. Los Voice Agents de Dyna.Ai se conectaron a su operación telefónica, gestionaron el primer contacto repetitivo y registraron los resultados; los empleados del banco siguieron a cargo de los casos que requerían criterio o seguimiento.
El banco comunicó una eficiencia de cobranza tres veces mayor y más de 1.000 llamadas salientes por hora. El ejemplo muestra por qué importan las capacidades de voz: forman parte de un flujo que debe contactar a los clientes, comprender sus respuestas y apoyar al equipo responsable de los pasos siguientes.
Voz con IA para la forma en que hablan los clientes
Un agente de voz multilingüe debe hacer más que reconocer varios idiomas. Tiene que responder a cómo se combinan, intervenir en el momento adecuado y llevar la intención del cliente al siguiente paso. Cada parte influye en el resultado de la conversación.
Dyna.Ai reúne voz multilingüe, gestión del diálogo y generación de voz en flujos empresariales para ayudar a los equipos a conversar con sus clientes de forma natural y avanzar sus solicitudes. Conoce Dyna.Ai Voice Agent.